1. ラボは加速している
午前3時の実験室を想像してみてください。照明はついているのに、誰もいません。ロボットアームが炉からるつぼを取り出し、X線回折装置へと運んでいきます。ソフトウェアが回折パターンを読み取り、今回の試行は狙いを外したと判断すると、レシピを調整して次の試行をキューに入れます。朝になる頃には、このシステムは大学院生が1か月かけてこなす以上の実験サイクルを回し終えています。しかも、コーヒー休憩も、ときどき襲ってくる「自分は何のために研究しているんだろう」という迷いもなしに。これが自律型ラボ(autonomous laboratory、またはself-driving lab)です。実験を計画し、実行し、結果を読み取り、次に何を試すかを決める。この一連のサイクルを、人がほとんど、あるいはまったく関わらずに回し続けるシステムです。
私がポスドクだった頃、こうした夢は誰かの基調講演の最後のスライド(「この分野がいつか向かうかもしれない未来」を語る、あのスライドです)にしか存在しませんでした。それが今では、NatureやScienceの論文に、実際に使われた手法として当たり前のように登場します。
こうしたアプローチが成熟するにつれ、資金も集まるようになりました。2026年7月、U.S. National Science Foundation(NSF)は、AIでプログラム可能なクラウドラボの全米ネットワークに4億ドルを投じました。これは、どこにいる研究者でも自分のワークフローで遠隔操作できる施設です(実は、Matlantisもそのひとつにパートナーとして参加しています)。Department of Energy(DOE)もGenesis Missionに2億9,300万ドルを投じると発表しており(連邦政府全体の拠出表明額は50億ドル近くにのぼります)、最初に選ばれたプロジェクトには、デジタルツインやクローズドループを掲げたものがずらりと並んでいます。民間資本も同じ方向に流れており、先端材料スタートアップの中には、連邦政府の助成金ですら誤差の範囲に見えるほどの資金を調達するところも出てきています。
目指すところは明確です。自律実験を、当たり前の研究インフラにすることです。
2. シミュレーションへの問い
実験がこれほど速く回るようになると、当然ひとつの問いが生まれます。この1年、私は何度もこの質問を受けてきました。
ロボットが今週だけで何百もの候補を合成して評価できるなら、そもそもなぜシミュレーションをする必要があるのか?
結局のところ、実験こそが「正解」なのだから、とにかくたくさん実験すればいいのでは?
もっともな疑問です。ただ、その答えは「実験の数で押し切る」ことではありません。100万回の実験をしようと提案している人など、誰もいないからです。自律型ラボでは、組成やプロセス変数に対するベイズ最適化によって、グリッドサーチに必要なサンプル数のごく一部で最適解にたどり着けます。ロボットの上に意思決定アルゴリズムを載せる意味は、まさにそこにあります。(ちなみに、ロボティクス、ベイズ的な意思決定、クローズドループなど、こうしたシステムの仕組みについての入門をお探しなら、以前公開したラボオートメーションの解説記事をご覧ください。)
シミュレーションベンダーとしての私たちの正直な答えはこうです。実験のスループットと計算による洞察は、それぞれ果たす役割が違います。そして一方を速くすれば、もう一方の価値が高まるのです。
その理由は、両者のスケールの仕方の違いにあります。実験のスループットは線形に伸びます(つまり、ロボットを2倍にすれば、週あたりのサンプル数も2倍になります)。しかし、探索空間のほうはそうはいきません。元素をひとつ、あるいはプロセス変数をひとつ加えるだけで、候補の数は組み合わせ爆発を起こします。そのため、ラボが速くなればなるほど、その速さを見当違いの領域に向けたときの代償は大きくなります。そして「ここは探さなくていい」と教えてくれる何かが、ますます欲しくなります。その何かこそが、原子レベルシミュレーションです。ただし、この流れは一方通行ではありません(これについては後ほど)。
要するに、原子レベルシミュレーションは単なる「あれば便利なもの」ではなく、発見のループそのものに欠かせない役割を担っているのです。本稿ではその理由を示し、さらにこの2つをどこまで緊密に結びつけられるのかを説明したいと思います。
3. これまでの役割分担
これまで、シミュレーションと実験は大きく2つの形で協働してきました。
役割1:ロボットが動き出す前に候補を絞り込む
まずは最もなじみのある形から始めましょう。数字で見れば、誰もが納得できる形だからです。ある課題を定義し、それほど大きくない多成分系の設計空間を設定します。いくつかの元素とその組成範囲、そしてひと握りのプロセス変数です。それだけで、候補は数百万にのぼります。1日100サンプルという驚異的なペースでも、その空間を実験で網羅的に調べるには数十年かかります。全候補を調べ終えて論文を出す頃には、定年を迎えているでしょう。ロボットの手前にある絞り込みは、計算で行うしかありません。
ここ数年で最も成功した取り組みのいくつかは、まさにこの形で組み立てられています。MicrosoftとPacific Northwest National Laboratoryの共同研究では、3,200万の電池材料候補が約80時間の計算で20数個にまで絞り込まれ、そのうちのひとつが実際に合成されて、動作する全固体電池のプロトタイプになりました。
Berkeley LabのA-Labも、同じ形で組み立てられています。A-Labの合成ターゲットは、安定と予測された化合物の計算スクリーニングから選ばれたものでした。そしてA-Labは17日間の連続稼働で、そのうち数十種類を合成しました[1]。
しかし、こうしたスクリーニングが実際に何をもたらすのかについては、注意が必要です。「これは良い触媒か」「これは良い電池か」を、あらゆる運転条件下で直接計算することはできません。代わりに計算するのは代理指標です。吸着エネルギー、拡散障壁、生成エネルギー、凸包(convex hull)からの距離などです。代理指標がマクロな観測量をどこまでうまく代弁できるかは、問題ごとに大きく異なります。
MetaのOpen Catalyst Experiments 2024(OCx24)は、その両面をはっきりと示した公開事例です。このチームは、572個の触媒サンプルを合成する実験と、計算を組み合わせました。計算側では、約2万の材料について6種類の反応中間体の吸着エネルギーを、6億8,500万回の機械学習加速による構造緩和で求めています[2]。水素発生反応(HER)については、計算スクリーニングが古典的な活性相関をほぼ再現し、白金を頂点に位置づけました。モデルの学習データに白金が含まれていなかったことを考えると、これは注目に値します。一方、CO2還元反応については、計算した記述子(descriptor)は、セル内で触媒が実際にどう振る舞うかを予測する指標としてはずっと弱いものでした。そこでの選択性は、単一の中間体がどれだけ強く吸着するかよりも、はるかに多くの要因に左右されるからです。
これはスクリーニングを否定する議論ではありません。むしろ、スクリーニングの使いどころを見極めるべきだ、という話です。計算による絞り込みは、絶対にうまくいかない候補を取り除くことには非常に長けています。そして候補のほとんどはそういうものです。一方で、生き残った上位候補の順位付けとなると、信頼性は下がります。計算が探索空間を、実験で回りきれる大きさまで絞り込み、何が本当に正しいかはラボが決める。より良い探索戦略だけでは問いに決着がつかないのも、これが理由です。
役割2:どの装置にも見えないものを見る
2つ目の役割は、スクリーニングとはまったく関係ありません。そして自動化されているかどうかにかかわらず、ラボを運営しているなら、こちらのほうがよく使うかもしれません。
自律型ラボは、合成が失敗したことは教えてくれますが、なぜ失敗したかは教えてくれません。目的の相が、より安定な副生成物に負けたのか? 中間体が生成した後に分解したのか? 回折パターンが記録するのは最終的な結果だけで、その途中で原子スケールに起きたことは、ラボのどの装置にも捉えられないまま消えていきます。これは私の思い込みではなく、実際の事例にも表れています。
先ほどのA-Labを例にとりましょう。チームが合成に失敗したケースを、計算で求めた反応の駆動力をもとに分析したところ、その多くから、ターゲットの選び方やレシピの設計をどう改善すればよいかが具体的に見えてきました[1]。回折パターンだけでは分からないことがあるのは、失敗例に限った話ではありません。成功とされた結果にも当てはまります。A-Labが報告した成果は後に改めて検証され、合成できたとされた40の化合物のうち、確認が取れたのは36でした。残る4つはX線データだけでは確認できず、さらに1つは、学習に使ったデータに誤って含まれていたため、検討の対象から外されました。合成そのものは、ロボットがきちんとこなしていました。けれども、実際に何ができたのかを回折パターンだけで見極めることはできません。その見極めこそ、物理モデルが力を発揮する場面です。
さらに、シミュレーションには物理的な実験では決してできないことがあります。条件を完全にそろえた「もしも」の比較ができることです。つまり、ひとつの変数だけを変え(たとえば欠陥をひとつ入れる、ドーパントをひとつ入れ替える、表面終端を変える)、それ以外はすべて固定したままシミュレーションできるのです。実験には想定外の結果がつきもので、その原因を説明するのに何週間もかかることがあります。そんなとき、条件をひとつずつ変えて確かめられるシミュレーションは、いわば不具合の原因を探す「デバッガー」の役割を果たします。たとえば、次のような場面です。
- あるはずのないピークを含むXRDパターンが得られた。そこで、考えられる競合相や準安定相の生成エネルギーを計算すると、午後のうちに犯人が見つかる。
- 10バッチにわたって安定していた物性が、新しいサンプルで突然ずれ始めた。一連の欠陥・不純物計算によって、どの混入物がその変化をもたらしうるかが明らかになる。
- ある基板ではきれいに成膜できる膜が、別の基板ではまったく核生成しない。前駆体の分解経路と表面反応障壁から、プロセスウィンドウを本当に左右している要因が分かる。
この種の解析が実際にどのようなものかを見てみたい方のために、メタノール合成触媒に関するケーススタディをまとめてあります[3]。中間体のIRスペクトルを計算してin-situ DRIFTと照合することで、表面に実際に何が存在するのかを特定しました。そして、その同じ構造像をもとに、安定性と活性の観点からドーパントのスクリーニングを行い、ラボで検証しました。選ばれた希土類ドープ触媒は、360 °Cでメタノール収率を最大28%向上させ、同時にCO副反応を抑制しました。この事例から分かるのは、(前述のOCx24と同様に)ひとつの理想化されたスラブモデルでは、スペクトルを再現することも、活性なドーパントと不活性なドーパントを区別することもできなかったという点です。しかし、現実的な表面構造を幅広く組み合わせることで、それが可能となりました。
こうした高速で物理に基づいたチェックは、事後解析だけでなく、ループの中に組み込むべきものです。
4. シミュレーションと実験はどこまで緊密に結びつけられるか:5つの段
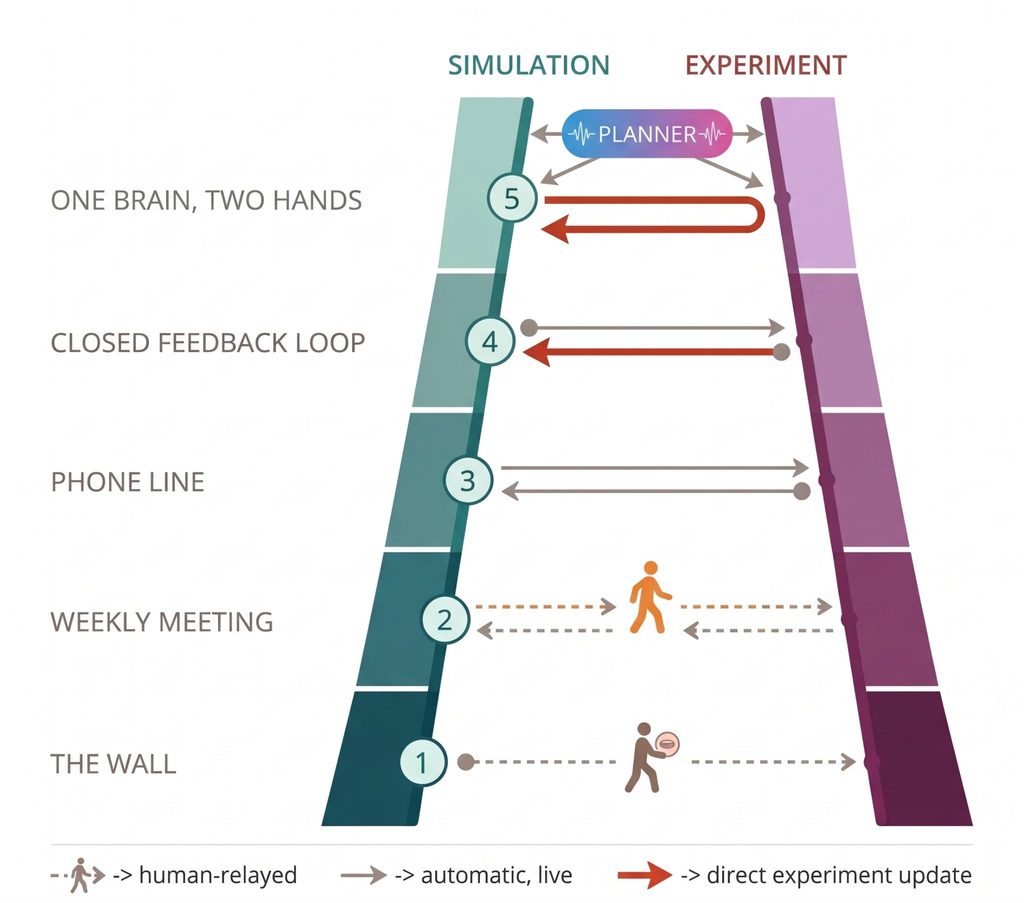
ここまで述べてきたことは、すべて一方向の流れでした。シミュレーションが実験に情報を与える、という流れです。しかし先日あるイベントで、とても興味深い質問を受けました。その流れは双方向になりうるのか? 実験結果がシミュレーションを良くすることはできるのか? 私はできると考えています。ただし、「シミュレーションと実験の協働」という言葉は非常に幅広い形態を含んでいるので、はしごの段に分けて考えると役に立ちます。
第1段:壁。 シミュレーションが先に走り、何かを手渡して、その後の結果を知らされることはありません。最有力とした候補が、炉で到達できるどんな温度でも合成できないとラボが突き止めても、スクリーニング側はそれを知る由もありません。そして次の四半期にも、その候補を何食わぬ顔でまた1位に挙げることになります。
第2段:定例会議。 両者が交代で作業し、その間を人間が結果を運びます。計算チームがスクリーニングし、ラボがテストし、木曜日に全員が集まって、もう片方のチームが前回から何をしていたのかをそこで知る。私もこうした会議には何度も出席してきました。本当に有益ではあるのですが、有望な結果が誰かのスライドの中で6日間も放置されてから、ようやく誰かが動き出す原因でもあります。
第3段:電話回線。 私が子どもの頃、電話回線というのは、相手とリアルタイムで話し、相手もその場で話し返してくれるためのものでした(念のため言っておくと、名字はYoung(若い)ですが、悔しいことに私も毎年しっかり歳をとっています)。質問をして、答えをもらい、調整する。ここでは、探索の途中で、システム自身が人間を介さずに電話をかけます。ロボットにある組成を試させる前に、プランナーが計算結果を先に確かめておきたいからです。
第4段:フィードバックループ。 ここで学習の向きが逆転し、探索の実行中に、実験結果が計算モデルを改善し始めます。終わったときのモデルは、始めたときのモデルとは別物になっています。そしてその違いは、ラボからもたらされたものです。
第5段:ひとつの頭脳と二本の手。 ここでは両者が互いを育て合います。実験がモデルを再学習させて次の予測をより鋭くし、より鋭くなったモデルが、ラボが試すべき範囲を絞り込む。1周ごとに、互いが互いを良くしていきます。その全体をひとつのプランナーが統括し、「実験を実行する」と「シミュレーションを実行する」を、ひとつの予算を奪い合う2つのアクションとして扱います。そして、1時間あたり、1ドルあたりで最も不確実性を減らせるほうを選びます。実験は遅く、高価で、しかし決定的です。シミュレーションは速く、安価で、しかし近似的です。そのためプランナーは、それぞれを最も見返りの大きいところに使うのです。
4a. で、みんなはどこにいるのか?
実際の研究がきれいにひとつの段に収まることはなく、面白いものほど複数の段にまたがっています。そこで、それぞれを無理にひとつの段に押し込むのではなく、文献全体がどのような様子なのかを概観してみましょう。
最近の優れた研究の多くは最初の2つの段の付近にいて、計算がどんな役割を担っているかを示しています。
たとえば、University of TorontoとKyushu Universityによる2026年の共同研究では、励起状態DFT計算によって252個のレーザー分子候補の仮想ライブラリが51個にまで絞り込まれ、そのすべてを自律型ラボが合成して光学特性を評価しました。その結果、これまで誰も報告していなかった、700 nmを超える近赤外発光体が見つかりました[4]。
RoboChemのプロトコルは、一見分かりにくいものの、興味深い事例です。その最適化アルゴリズムが7種類のパラジウムプレ触媒の中から選ぶ必要があったとき、どれとどれが似ているかを教えたのは、公開されている配位子ライブラリからDFTで計算された記述子の一式でした。後にチームが基質を切り替えたとき、わずか4回の追加実験で収束できたのも、この記述子のおかげです[5]。
一方で、さらに上の段に位置する研究もあります。
たとえば、A-Labを開発したのと同じBerkeleyのグループは、固相合成のための自律システムを構築しました。このシステムは、探索の途中で前駆体の組み合わせ候補について熱力学的駆動力を計算し、目的の相に到達する可能性が最も高い組み合わせを選び、試行が失敗すれば選び直します[6]。
AMASEはさらに一歩進んでいます。各回折結果をCALPHADにフィードバックし、CALPHADがパラメータを再フィットして次に測定する温度を選ぶことで、Sn-Bi薄膜の状態図を1回の無人実行で描き直しました。グリッドサーチなら400点の測定が必要なところを、わずか66点で、です[7]。
Argonneの別の研究は、同じことをもう一段深いレベルで行いました。熱力学モデルではなく、酸化ハフニウムの機械学習ポテンシャル(MLIP)そのものを回折データから再学習させたのです[8]。
最後に、最近の研究では、こうした考え方を薄膜成長に応用しています。CrTaWV-Mo組成傾斜ライブラリ上で自律的にAFM測定を行い、測定した表面粗さを、その都度kinetic Monte Carlo(kMC)モデルにフィードバックします。kMCモデルは膜と一致するまで結合エネルギーを調整し直し、汎用的な成長モデルをその合金に特化したモデルへと変えていきます[9]。著者らの言葉を借りれば、kMCモデルは測定からパラメータを更新するにつれて「徐々に材料固有の『デジタルツイン』へと進化していく」のです。
このように、少なくとも実験側については、第5段のシステムを構成する要素はすでに揃っています。原子レベルシミュレーションはすでにこの流れに加わっていて、実験によってチューニングすることもできます。さらに、それらを計画・実行するエージェント型フレームワークも実はすでに登場しており、第5段のシステムのもう半分を構成しています。これについては、もう少し後で触れます。
5. 原子レベルシミュレーションをループに組み込むには:Matlantisの取り組み
予測のランキングを手渡されたことのある実験家なら誰しも、1位の候補が実際にどうだったかという話をひとつは持っています(つまり、うまくいかずにゴミ箱行きになった話です)。この差は確かにあります。ただ、産業の現場では、そもそも精度の問題ですらないことがよくあります。むしろ、シミュレーションが100個の原子を1ナノ秒扱うのに対し、製品は数ミクロンの大きさがあり、10年間もたなければならない、という問題なのです。計算自体は、設定した問いには正しく答えていることが多いのです。進行中の探索の中に物理を組み込むために本当に変わるべきなのは、速度、到達範囲、そして計算の専門家でなくても使えるかどうか、です。
5a. 速度とスケール
3週間かかる計算は、実験と並走する相棒ではなく、事後検証のための道具です。そして、従来の量子力学計算がロボットのペースについていけないことは、すでによく知られています。MLIPがこの状況を変え、汎用ポテンシャルは、系ごとのモデル開発というステップをなくすことで、さらに一歩進めました。これはループの中では重要です。探索は予期しない問いを投げかけてくるものであり、来るかどうかも分からない問いのために、専用のモデルを事前に学習させておくことはできないからです。
一方で、スケールも速度と同じくらい重要です。DFTが事実上、数百原子・ピコ秒の範囲に限られるのに対し、MLIPははるかに大きな系を、はるかに長い時間扱えます。その到達範囲こそが、原子レベルの物理を製品のスケールに少しでも近づける手段でもあります。さらに、MLIPを粗視化手法、マイクロキネティクス、kMC、フェーズフィールド法などと組み合わせれば、その到達範囲はさらに広がります。
当社の汎用MLIPであるMatlantis PFPは、材料ごとのモデル開発なしに、96元素にわたって参照DFTに迫る精度を実現しています[10]。そして独自の推論システムであるPFVMによって、計算待ちの列(キュー)に並ぶのではなく、ループの中に入れるだけの速さを実現しています[11]。PFPで扱える範囲は、一般に思われているより広いものです。たとえば最近の研究では、水中のPETase酵素全体を対象に、PET加水分解反応を全原子で扱っています[12]。また、これは私たち自身の評価だけではないことも付け加えておきます。MLIP Arenaは、固定されたDFT参照値に対する誤差ではなく、物理的な妥当性と現実の挙動でポテンシャルを評価する第三者ベンチマークです。そこで最新のPFPは、MACE-MPAと並んで総合1位タイとなり、個別タスクのうち3つで1位を獲得しました(これはどのポテンシャルよりも多い数です)[13]。
最後に、PFPはいくつかの方向に拡張できます。OpenMMのような確立されたエンジンと組み合わせればより大きな系を扱えるようになり、金属とポリマーの界面における界面熱抵抗の計算が現実的になったのも、これによるものです[14]。また、PFP Descriptorsは、モデルが内部で構築する特徴ベクトルを取り出せるようにします。これを使えば、誰もカタログ化していない探索空間をマッピングしたり、XRD、スペクトル、画像といった自社の測定データと一緒にその特徴量をモデルに入力したりできます。こうして、シミュレーションと実験がひとつの予測モデルを一緒に学習させるのです[15]。
5b. アクセス
速度が上がっても、2つ目の障壁はなくなりません。それは、シミュレーションを使うのに計算の専門家並みの熟練が必要なら、多くの人の役には立たないということです。実験家と計算のあいだにあった壁の多くは、計算を使いこなすための専門知識でした。手法を適用するだけでなく、シミュレーションを実行するには、解くべき問題の範囲の見極め、構造ファイルの準備、条件設定とパラメータ調整、ベンチマーク、結果の集計が必要です。
最近、エージェントがその壁を取り壊し始めています。たとえばQUASARは3つのエージェントからなるシステムで、DFT、MLIP、MD、モンテカルロ法をカバーし、要求に応じてコストと精度のバランスをとり、公開済みの光触媒スクリーニングを人間の指示なしに再現しました[16]。別の例として、Argonneによる最近のシステムは、構造生成から解析まで11のエージェントを連携させ、障害からの回復機能も組み込んでいます[17]。ユーザーが自然言語のプロンプトを管理者エージェントに渡すと、管理者エージェントはLAMMPSの専門エージェントたちに作業を振り分けます。専門エージェントは構造を構築し、適切な原子間ポテンシャルを探し出し、ジョブを書いて投入し、出力を解析します。実行がエラーになると、フレームワークは自分でスクリプトを修正し、通るまで再投入します。そして検証された元素や合金については、チームの専門家が手作業で出した値に近い結果が得られました。
Matlantisでも、この課題に取り組んでいます。問題のひとつは、汎用のコーディングエージェントはMatlantisを見たことがない、ということです。そのため、もっともらしいコードを、自信満々に、しかも間違って書いてしまいます。足りないのは、学習データに含まれていなかったドメイン知識です。そこで私たちは、Matlantisの関数、API、代表的なワークフローを、エージェントが読み込んで参照できる形にまとめたSkillsライブラリをGitHubで公開しました[18]。Claude Code、Codexなどで動作し、インストーラーを使えばMatlantisのターミナル内でClaude Codeを実行できます。やりたいことを普段の言葉で説明し、スクリプトを生成・編集し、実行し、出力を読む。そのすべてを、環境から離れることなく行えます。
ロボットが実験の手作業を自動化したように、今度はエージェントが計算の手作業を自動化しつつあります。変わるのは、速度というよりも、誰が問いを立てられるか、です。計算の実行に専門家の1週間を費やす必要がなくなれば、これまでわざわざ頼むほどでもなかった小さな問いも、問われるようになるのです。
6. おわりに
自律型ラボは、現在の材料R&Dにおいて最もエキサイティングな進展のひとつです。同時に、シミュレーションの使い方を見直すきっかけでもあります。実験が速くなればなるほど、シミュレーションの価値は高まります。スループットと洞察は、もともと同じ資源ではないからです。ですから、本当に考えるべきは両方を使うかどうかではなく、両者をどこまで緊密に結びつけるか、です。ただし、はしごの段は順位表ではありません。第5段がゴールなわけでも、第1段が失敗なわけでもありません。適切な結びつき方は、取り組む課題と、間違った答えがどれだけの代償を伴うかによって決まります。段を並べてみせたのは、どこまで登るべきかを指図するためではありません。自分のワークフローのどこに計算が最もよくフィットするかを考えるための、ひとつの枠組みです。
ラボだけがすべてではありません(The lab is not all you need)。だからこそ、千回目の実験と、結局飲みそびれたコーヒーのあいだのどこかで、少し立ち止まって、シミュレーションの香りも楽しんでみてください。
参考文献
[1] N. J. Szymanski et al., “An autonomous laboratory for the accelerated synthesis of inorganic materials,” Nature 624, 86–91 (2023), doi:10.1038/s41586-023-06734-w. Author Correction: Nature 650, E1 (2026), doi:10.1038/s41586-025-09992-y.
[2] J. Abed et al., “Open Catalyst Experiments 2024 (OCx24): Bridging Experiments and Computational Models,” arXiv:2411.11783 (2024), doi:10.48550/arXiv.2411.11783.
[3] Matlantis, “メタノール合成触媒の計算と実証,” https://matlantis.com/ja/calculation/calculation-and-verification-of-methanol-synthesis-catalysts
[4] H. S. Park, M. Mazaheri, C. Choi, H. Hao, D. Avagliano, E. Isbrandt, B. S. B. Karunathilaka, C. Adachi, A. Aspuru-Guzik, “Discovery of tunable and soluble organic emitters for solid-state lasers with a self-driving laboratory,” Nature Communications 17, 2920 (2026), doi:10.1038/s41467-026-69233-2.
[5] S. Pilon et al., “A flexible and affordable self-driving laboratory for automated reaction optimization,” Nature Synthesis (2026), doi:10.1038/s44160-026-01053-0; T. Gensch et al., “A comprehensive discovery platform for organophosphorus ligands for catalysis,” J. Am. Chem. Soc. 144, 1205–1217 (2022), doi:10.1021/jacs.1c09718.
[6] N. J. Szymanski, P. Nevatia, C. J. Bartel, Y. Zeng, G. Ceder, “Autonomous and dynamic precursor selection for solid-state materials synthesis,” Nature Communications 14, 6956 (2023), doi:10.1038/s41467-023-42329-9.
[7] H. Liang, C. Wang, H. Yu, D. Kirsch, R. Pant, A. McDannald, A. G. Kusne, J.-C. Zhao, I. Takeuchi, “Real-time experiment-theory closed-loop interaction for autonomous materials science,” Science Advances 11, eadu7426 (2025), doi:10.1126/sciadv.adu7426.
[8] G. Sivaraman, L. Gallington, A. N. Krishnamoorthy, M. Stan, G. Csányi, Á. Vázquez-Mayagoitia, C. J. Benmore, “Experimentally Driven Automated Machine-Learned Interatomic Potential for a Refractory Oxide,” Physical Review Letters 126, 156002 (2021), doi:10.1103/PhysRevLett.126.156002.
[9] B. N. Slautin, K. Barakati, Y. Liu, R. Emery, P. Rack, S. V. Kalinin, “Bayesian Conavigation of a Computational Physical Model and Atomic Force Microscopy Experiment to Autonomously Survey a Combinatorial Materials Library,” ACS Nano (2026), doi:10.1021/acsnano.6c03268.
[10] S. Takamoto et al., “Towards universal neural network potential for material discovery applicable to arbitrary combination of 45 elements,” Nature Communications 13, 2991 (2022), doi:10.1038/s41467-022-30687-9. For the 96-element coverage, see PFP v7 release (Matlantis, 2024),https://matlantis.com/ja/news/pfp-v7-release/, and C. Shinagawa et al., “Matlantis-PFP v8: Universal Machine Learning Interatomic Potential with Better Experimental Agreements via r2SCAN Functional,” arXiv:2603.11063 (2026), doi:10.48550/arXiv.2603.11063.
[11] Matlantis, “AIモデル 「Matlantis PFP」 とは”,https://matlantis.com/ja/product/about-pfp/.
[12] M. Yamauchi, M. Sato, “Whole-Enzyme Reactive Free-Energy Simulations with a Universal Machine Learning Interatomic Potential: Catalytic Mechanism and Mutational Effects of PETase,” ChemRxiv (2025), doi:10.26434/chemrxiv.15004671.
[13] Matlantis, “Matlantis PFP v9、機械学習ポテンシャルの公開ベンチマーク「MLIP Arena」の総合ランキングで同率1位” (2026),https://matlantis.com/ja/news/pfp-v9-mlip-arena/. Benchmark: Y. Chiang et al., “MLIP Arena: Advancing Fairness and Transparency in Machine Learning Interatomic Potentials via an Open, Accessible Benchmark Platform,” NeurIPS 2025, https://openreview.net/forum?id=SAT0KPA5UO; leaderboard values as of March 1, 2026.
[14] Matlantis, “金属-ポリマー接合構造における界面熱抵抗計算,”https://matlantis.com/ja/calculation/interfacial-thermal-resistance-calculation-at-a-metalpolymer-interface/.
[15] Preferred Networks Tech Blog, “The Power of PFP Descriptors: Enhancing Prediction Tasks with Pre-trained Neural Network Potentials” (2025), https://tech.preferred.jp/en/blog/the-power-of-pfp-descriptors-enhancing-prediction-tasks-with-pre-trained-neural-network-potentials/.
[16] F. Yang, J. D. Evans, “QUASAR: A Universal Autonomous System for Atomistic Simulation and a Benchmark of Its Capabilities,” J. Chem. Inf. Model. 66(10), 5911–5918 (2026), doi:10.1021/acs.jcim.6c00295.
[17] A. Vriza, U. Kornu, A. Koneru, H. Chan, S. K. R. S. Sankaranarayanan, “Multi-agentic AI framework for end-to-end atomistic simulations,” Digital Discovery 5, 440–452 (2026), doi:10.1039/D5DD00435G.
[18] Matlantis, “Matlantis、AIエージェント連携機能を提供開始,”https://matlantis.com/ja/news/release-260527/.
-


 URLを
コピーしました