目次
前半・後半の 2 回に分けて、次の順に解説します。
前半
- 連続最適化の前提知識
- アルゴリズム解説
- 最急降下法
- 直線探索法(Line Search)
- ニュートン法
後半
- 前半のおさらい
- アルゴリズム解説
- BFGS
- L-BFGS
はじめに
計算化学で構造最適化を実行するとき、あるいはマテリアルズインフォマティクス(MI)で機械学習モデルを学習させるとき、裏側では「連続最適化」のアルゴリズムが動いていることが多いです。構造最適化のオプティマイザとしてL-BFGS を選んだり、機械学習ライブラリの設定でL-BFGS という名前を見かけたりしたことがある方も多いのではないでしょうか。本記事は、計算化学やMIで広く使われるL-BFGS法を最短ルートで理解することを目的とし、化学を専門とする方にもイメージしやすいよう解説を進めます。前半では、連続最適化に必要な前提知識からニュートン法までを解説し、L-BFGSを含む準ニュートン法は後半で扱います。
連続最適化とは、連続変数で表される関数 𝑓(𝑥) の最大値・最小値およびそれを与える 𝑥を求める問題です。例えば
- 計算化学における構造最適化: 原子座標を動かして、ポテンシャルエネルギーを最小にする
- 機械学習の学習: モデルのパラメータを動かして、予測値と実測値のずれ(損失関数)を最小にする
はどちらも連続最適化の問題です。MI の全体像については、以前の記事「マテリアルズインフォマティクス(MI)とは?基本的な考え方から最新の研究までをわかりやすく解説」もあわせてご覧ください。
本記事では代表的なアルゴリズムを、簡単な 2 変数関数でのデモンストレーションとともに紹介し、それぞれのアイデア・メリット・デメリットを直感的に理解できるよう解説していきます。本文ではイメージの理解を優先しています。より深く知りたい方は末尾の参考文献をご参照ください。
なお、最大化は 𝑓 を −𝑓 に置き換えるだけで最小化と等価になるため、以降はすべて最小化で話を進めます。また、本記事で扱う手法はいずれも「出発点の近くにある極小」を探す手法です。得られる解は必ずしも全体で最も小さい点ではない、という点は頭に置いておいてください。構造最適化でいえば、得られるのは初期構造の近くにある安定構造であり、最も安定な構造とは限りません。
※本記事の「安定構造」とは、ポテンシャルエネルギーが極小となる構造を指します。
計算化学と MI での「𝑥」と「𝑓」
本記事では数学の記号で話を進めますが、それぞれの分野に置き換えると次のようになります。
計算化学の構造最適化では、変数 𝑥 は原子座標(𝑁 原子なら 3𝑁 個の数)、目的関数 𝑓 はポテンシャルエネルギーです。(※以下、エネルギー=ポテンシャルエネルギーとして進めます) エネルギーは密度汎関数理論(DFT)や機械学習ポテンシャルなどで計算します(それぞれ「【初心者向け】密度汎関数理論(DFT)とは | 基礎編」、「機械学習ポテンシャル入門: 材料開発を加速するシミュレーション技術」で解説しています)。エネルギーを座標で微分した勾配は、符号を反転させると原子に働く力そのものです。この力は分子動力学(MD)で原子を動かすのにも使われます(「分子動力学シミュレーション入門」)。エネルギーが極小になる点が安定構造に対応します。
MI などの機械学習では、変数 𝑥 はモデルのパラメータ(回帰係数やニューラルネットワークの重み)、目的関数 𝑓 は損失関数(例えば、予測した物性値と実測値の二乗誤差の平均)です。損失関数が最小になるパラメータが、データに最もよく当てはまるモデルに対応します。
前提知識: テイラー展開と「勾配ゼロ」の意味
最適化アルゴリズムを理解するうえで欠かせないのがテイラー展開です。滑らかな関数 𝑓 は、点 𝑥 のまわりで次のように展開できます。
f(x + d) = f(x) + ∇f(x)⊤d + 12d⊤∇2f(x) d + (𝑑の3 次以上の項)
ここで登場する 2 つの量が本記事の主役です。
- ∇𝑓(𝑥) ― 勾配。各変数についての 1 階偏微分を並べたベクトルで、その方向は「関数が最も急に増加する向き」を表します。構造最適化では、原子に働く力の向きを反転させたものです。
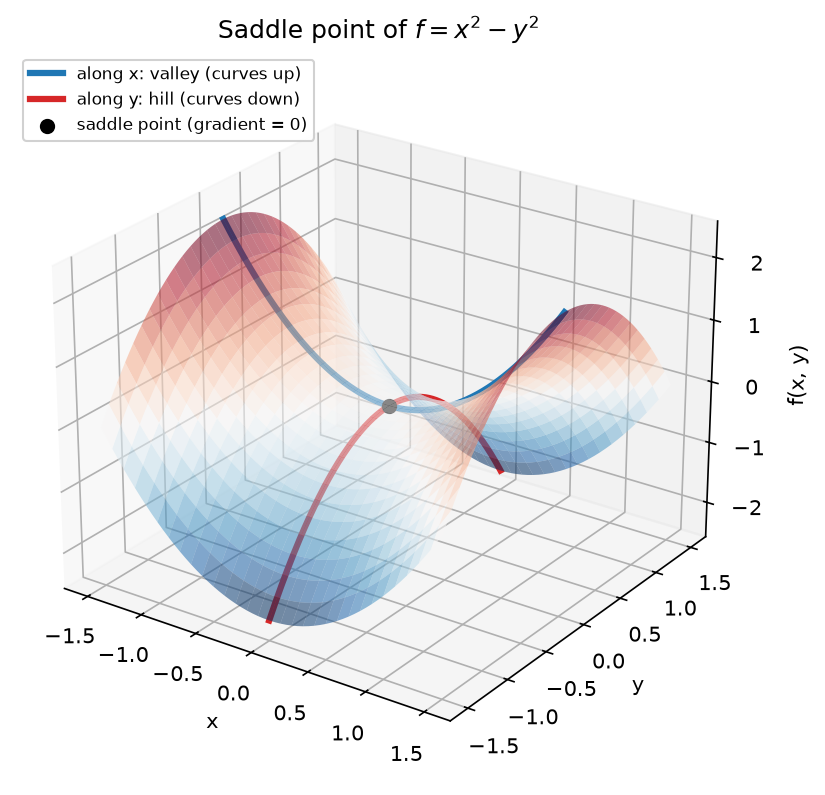
- ∇²𝑓(𝑥) ― ヘシアン(ヘッセ行列)。第 (𝑖, 𝑗) 要素が ∂²𝑓/∂𝑥ᵢ∂𝑥ⱼ となる行列で、関数の局所的な曲がり具合(曲率)を表します。計算化学では、振動数計算で分子の基準振動数を求めるときに計算しているのがこのヘシアンです(正確には原子の質量で重み付けしたもの)。極小点のまわりではどの方向に見ても下に凸な谷、極大点のまわりではどの方向に見ても上に凸な山です。ある方向から見ると山型なのに、別の方向から見ると谷型になっている点もあり、鞍点と呼ばれます(Figure 1)。化学反応の遷移状態はまさにこの鞍点で、反応が進む方向には山、それ以外の方向には谷になっています。
𝑥⋆ が極小点であるための必要条件は、そこで勾配が”ゼロ”になっていることです:
∇f(x⋆) = 0.
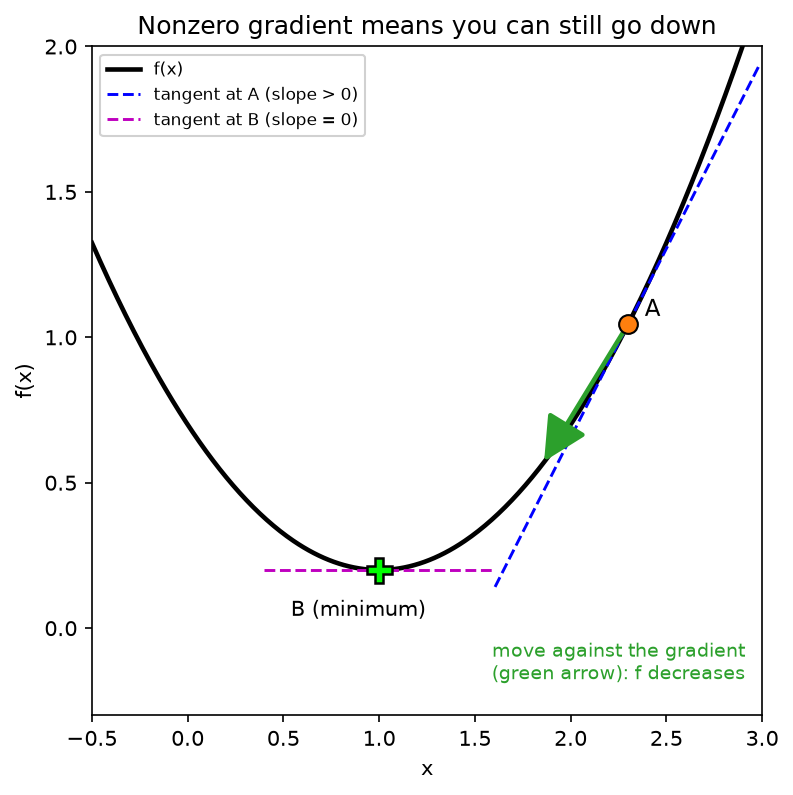
勾配がゼロでない点では、勾配と逆向きにわずかに動くだけで関数値を下げられるため、極小点ではありません(Figure 2)。
さらに、勾配がゼロであることに加えてヘシアンが谷を表していれば、その点は極小点であると言えます。構造最適化の言葉では「すべての原子に働く力がゼロ」が必要条件で、「振動数計算で虚振動がない」ことが極小であることの確認に対応します。
連続最適化アルゴリズムの多くは、この「勾配がゼロになる点を探す」という問題を、テイラー展開の何次までを使うかという観点で設計されています。
本記事のデモにおける収束判定
以降のデモでは、収束条件を「勾配の成分の絶対値の最大値が 0.01 未満になったら終了」で統一します。勾配がゼロになる点を探しているので、勾配が十分小さくなったら止める、という考え方です。
これは計算化学の構造最適化でよく使われる判定と同じ考え方です。例えば ASE では「各原子に働く力の大きさの最大値が fmax 未満」を収束条件にしています。一方、機械学習の学習では、決まった回数だけ更新を繰り返すことや、検証用データでの損失が改善しなくなったところで止めることもあります。
最急降下法 (Steepest Descent / Gradient Descent)
最も基本的なアルゴリズムで、点 𝑥ₖ から勾配と逆方向に進む方法です。
xk+1 = xk − α∇f(xk),
ここで 𝛼 > 0 はステップ幅です。機械学習では「学習率」とも呼ばれます。構造最適化の言葉では「各原子を、働いている力の向きに少しずつ動かす」、機械学習の言葉では「損失が減る向きにパラメータを少しずつ動かす」という、最も素朴な方法です。
勾配は「関数が最も急に増える向き」なので、その逆向きは「最も急に減る向き」です。少しだけ動く範囲では、勾配の逆向きに進むのが最も効率よく関数値を下げる方法になります。
最急降下法がうまくいく例
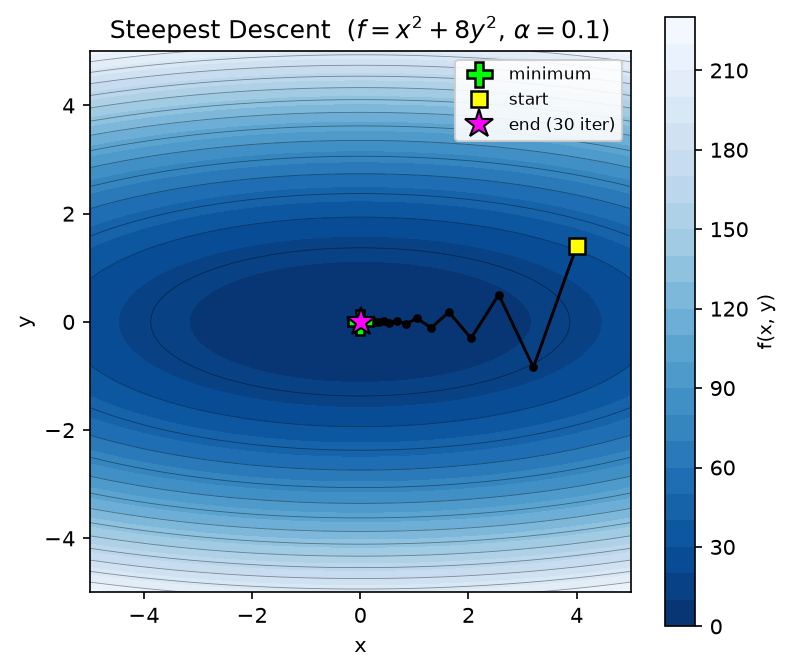
細長い谷をもつ二次関数 𝑓(𝑥, 𝑦) = 𝑥² + 8𝑦² を、初期点 (4.0, 1.4)、𝛼 = 0.1 で最小化します。その様子をFigure 3に示します。30ステップで最小値にたどり着くことができています。
最急降下法の難しさ
Figure 3を見ると、反復の後半で1ステップあたりの更新量が小さくなり、なかなか収束しない様子が観察できます。なぜこのような挙動になるのでしょうか。これは「関数の形状(条件数)」と「ステップ幅𝛼の設定」に関する難しさに起因しています。
この関数は、𝑦 方向の曲がり具合(曲率)が 𝑥 方向の 8 倍もあります(ヘシアンの固有値が 2 と 16)。この「最も急な方向と最も緩やかな方向の曲率の比」を条件数と呼びます。条件数が大きいと谷が細長くなり、勾配ベクトルは谷底ではなく谷の壁のほうを向いてしまいます。その結果、曲率の大きい 𝑦 方向では振動し、曲率の小さい 𝑥 方向ではゆっくりとしか進まない、ということが起こります。
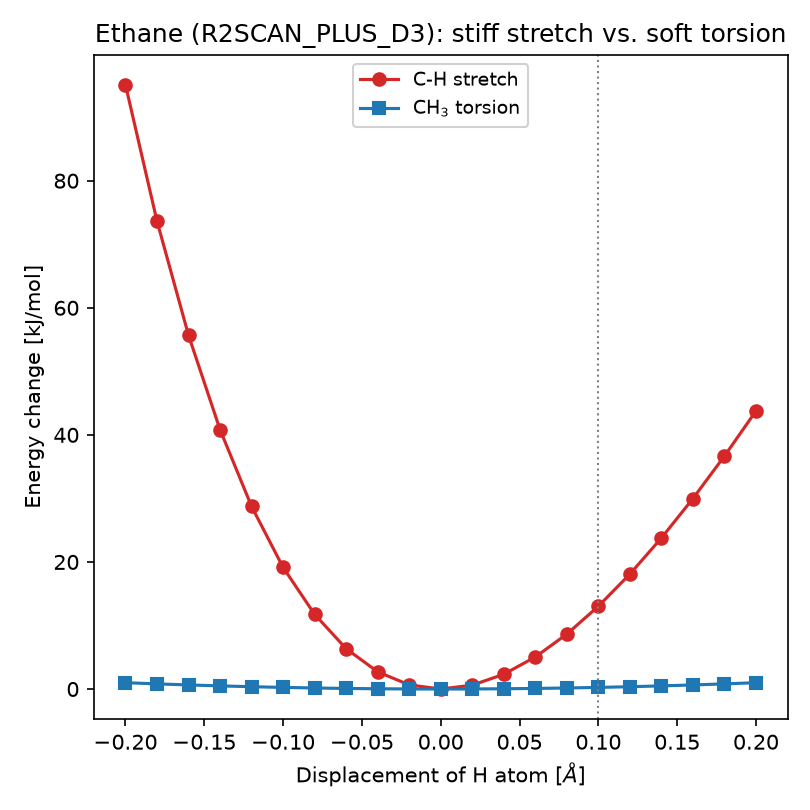
この「条件数の大きさ」は、実際の分子における構造最適化でも頻繁に直面する問題です。分子には、硬い結合の伸縮(曲率が大きい)と、柔らかいねじれ(曲率が小さい)が混在しているため、条件数が大きくなりがちです。例えばエタン(CH₃–CH₃)について Matlantis PFP v9(R2SCAN_PLUS_D3 モード)で計算してみると、C–H 結合を 0.1 Å 伸ばすとエネルギーは約 13 kJ/mol 上がるのに対し、C–C 結合まわりにメチル基をねじって3つのH原子をそれぞれ0.1 Å 動かしても、約 0.26 kJ/mol しか上がりません(Figure 4)。同じだけ原子を動かしたときのエネルギーの上がり方で約 50 倍、谷底での曲がり具合(曲率)で比べると約 60 倍の開きがあります。機械学習でも、特徴量のスケールがばらばらだと同じ状況になり、学習前に特徴量を標準化する理由の1つとしてこれがあります。
最急降下法が失敗する例
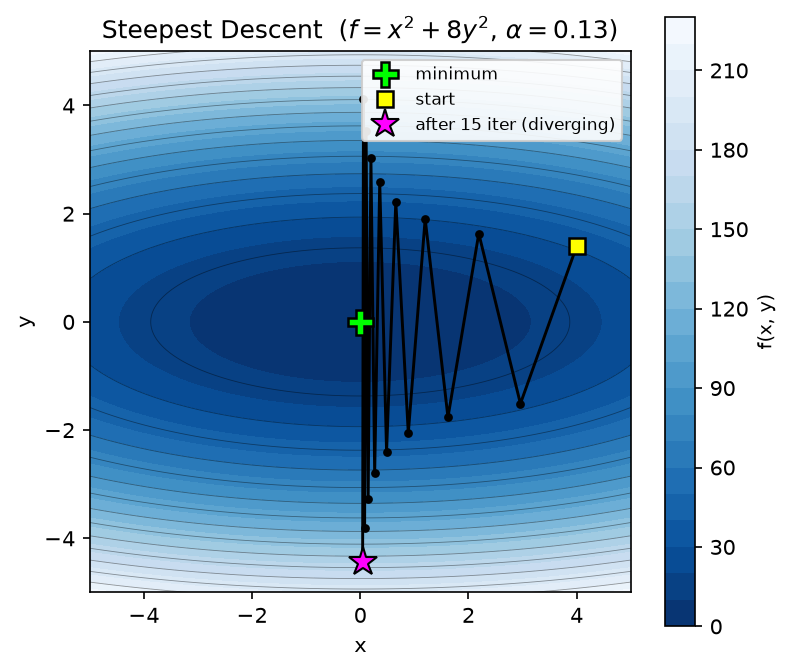
同じ関数・同じ初期点で、ステップ幅をわずかに大きくして 𝛼 = 0.13 で実行してみます。その結果、最適化は発散してしまいました(Figure 5)。ステップ幅が大きすぎたため、曲がり具合の大きい 𝑦 方向では 1 ステップごとに谷を飛び越えてしまい、しかも飛び越えるたびに反対側の斜面のより高い位置に着地するようになったためです。
最急降下法のメリットとデメリット
- メリット: 実装が簡単。勾配さえあれば動く。
- デメリット: ステップ幅 𝛼 の選択が難しい。𝛼が小さいと収束が遅く、少し大きいだけで発散することがある。
直線探索法(Line Search) ― ステップ幅を賢く決める
最急降下法の難しさは「良い 𝛼 を事前に選べないこと」でした。Line Search は、進む方向 𝑑ₖ を決めたあと、その方向に沿ってどれだけ進むか(𝛼)を、ステップごとに関数値が十分減るように選ぶ手法です。
Armijo (アルミホ) 条件
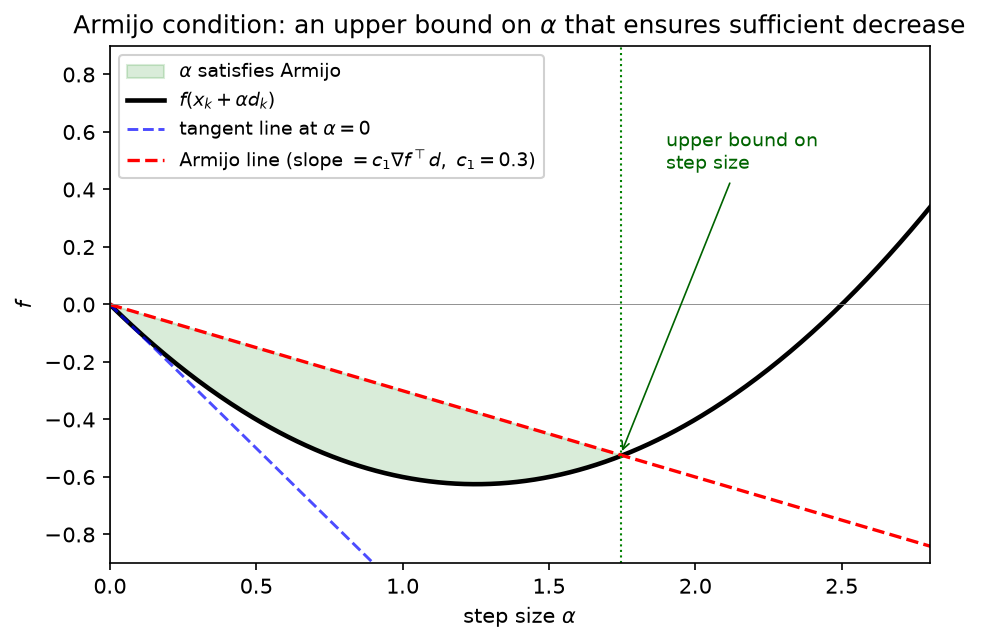
最も基本的なのが Armijo 条件で、次を満たす 𝛼 を「十分に関数値が減った」として受け入れます。
f(xk + αdk) ≤ f(xk) + c1α∇f(xk)⊤dk, 0 < c1 < 1.
右辺は、出発点での坂の傾きを 𝑐₁ 倍に緩めた直線です。実際の関数値がこの直線を下回っていれば合格、という条件で、イメージは「𝛼 を伸ばしすぎない上限を課す」ことです。𝑐₁ は 10⁻⁴ 程度の小さな値がよく使われます1。これを満たす𝛼は𝛼 = 1 から始めて、条件を満たすまで 𝛼 を半分にし続けるバックトラッキングなどを用いて探索します。
Wolfe (ウルフ)条件
Armijo 条件だけだと、𝛼 を極端に小さく取っても条件を満たしてしまい、進みが遅くなることがあります。そこで、Armijo 条件に加えて「進んだ先では、出発点よりも坂が緩やかになっている」ことも要求する Wolfe 条件がよく使われます。まだ急な下り坂が続いているなら、もっと先まで進めるはずだ、という考え方で、𝛼 が小さすぎることを防ぎます。式で書くと、Armijo 条件に加えて次を課します。
∇f(xk + αdk)⊤dk ≥ c2 ∇f(xk)⊤dk, 0 < c1 < c2 < 1.
左辺は進んだ先での坂の傾き、右辺は出発点での坂の傾きを 𝑐₂ 倍したもので、下り坂ならどちらも負の値です。進んだ先の坂が出発点より十分に緩やかになっていることを要求する条件で、これが 𝛼 の下限を決めます。
さらに、進みすぎて坂を登り始めてしまうことまで防ぎたい場合は、この式の両辺を絶対値にした強 Wolfe 条件を使います。
|∇f(xk + αdk)⊤dk| ≤ c2|∇f(xk)⊤dk|.
パラメータは、後半で紹介する準ニュートン法などでは 𝑐₁ = 10⁻⁴、𝑐₂ = 0.9 程度が標準的です1。
なお、Armijo 条件がステップ幅の上限を決めるのに対し、Wolfe 条件の追加部分は下限を決めます。そのため、ステップ幅を縮めるだけのバックトラッキングでは Wolfe 条件を満たせないことがあります。そこで実装では、長すぎれば縮め、短すぎれば伸ばす、という探索を行います。
最急降下法+Line Searchの例
Figure 3と同じ関数・同じ初期点で、最急降下法 + Line Search(強 Wolfe 条件)を実行した結果をFigure 7に示します。毎回ステップ幅が自動調整されるため、30ステップかかった最適化が4ステップまで短縮できています。
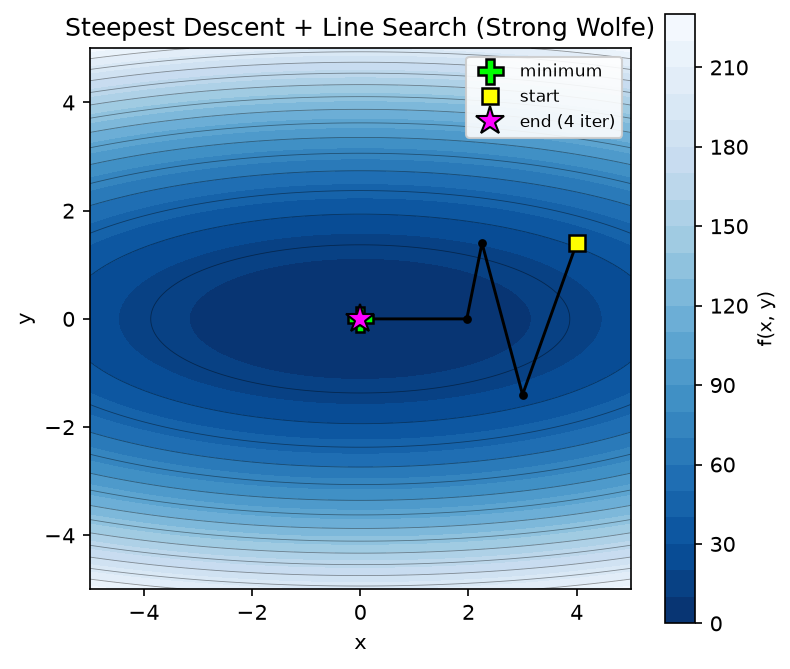
Line Search は最急降下法だけでなく、後半で紹介する BFGS・L-BFGS など、様々な手法と組み合わせて使われる手法です。ただし、Line Search では1ステップの中で関数値や勾配を何度も計算することがあります。DFT のように 1 回のエネルギー・力の計算コストが高い場合には、この追加コストが無視できない点に注意が必要です。
ニュートン法 (Newton’s Method)
最急降下法はテイラー展開の 1 次(勾配)までしか使いませんでした。ニュートン法は 2 次(ヘシアン)まで使います。
2 次まで使うと、関数を現在の点のまわりで二次関数で近似できます。その近似した二次関数の谷の底に一気に飛ぶのがニュートン法です(近似が谷にならない場合にどうなるかは後で見ます)。
まずは変数が 1 つの場合で考えてみましょう。点 𝑥 から 𝑑 だけ動いたときの関数値は、テイラー展開を 2 次まで使うと
f(x + d) ≈ f(x) + f ′(x) d + 12f ″(x) d2
と近似できます。右辺は 𝑑 についての二次関数です。その底では 𝑑 で微分した傾きがゼロになるので、
f ′(x) + f ″(x) d = 0 ⇒ d = −f ′(x)f ″(x)
が、近似した谷の底まで進む量になります。つまり「傾き」を「曲がり具合」で割ったものです。傾きが同じでも、急に曲がっている(𝑓″ が大きい)谷なら底はすぐ近くにあるので少しだけ動き、緩やかに曲がっている(𝑓″ が小さい)谷なら底は遠くにあるので大きく動く、というわけです。
変数が複数ある場合は、傾き 𝑓′ を勾配 ∇𝑓 に、曲がり具合 𝑓″ をヘシアン ∇²𝑓 に置き換えます。行列での「割り算」は逆行列を掛けることにあたるので、進む量は
dk = −[∇2f(xk)]−1∇f(xk), xk+1 = xk + dk
となります。方向ごとに曲がり具合で割ってくれるので、曲率の大きい方向は控えめに、曲率の小さい方向は大きく動くことになり、最急降下法のジグザグが起こりません。
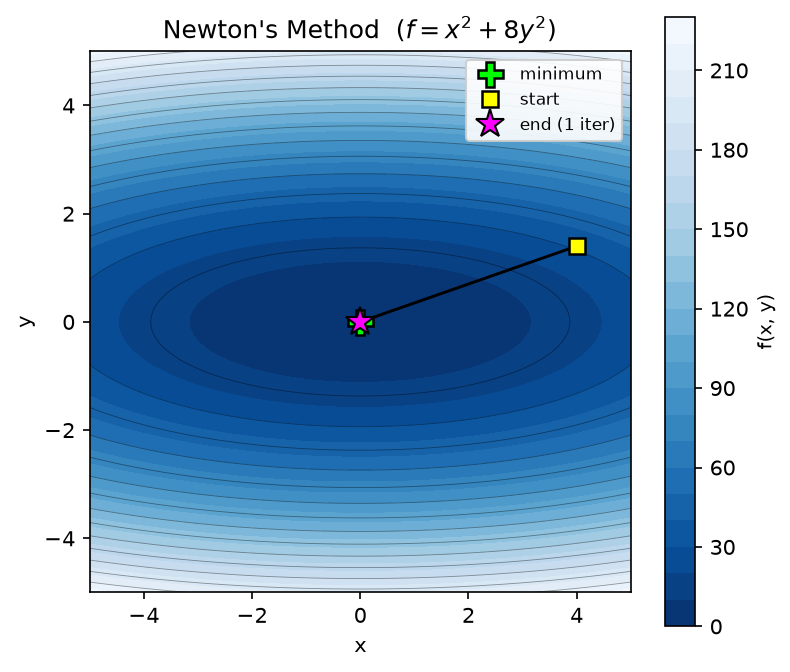
関数が局所的に二次関数とよく一致する領域では、最急降下法よりはるかに少ない反復で収束します。実際、𝑓 が谷型の二次関数なら、ニュートン法は 1 ステップで解に到達します。
ニュートン法がうまくいく例
先ほどの 𝑓(𝑥, 𝑦) = 𝑥² + 8𝑦² を、同じ初期点 (4.0, 1.4) からニュートン法で最適化した結果をFigure 8に示します。1 ステップで解に到達しているのが確認できました。
ニュートン法が失敗する例
ニュートン法は「勾配がゼロになる点」を探しているだけで、それが極小点か、極大点・鞍点かを区別しません。山型の領域で 2 次近似をすると、近似は「谷」ではなく「山」になり、ニュートン法はその山の頂上に飛んでしまいます。例として、以下の 4 つの極小と原点に極大を持つ関数を考えます。
f(x, y) = 14(x4 + y4) − 12(x2 + y2)
極小は (±1, ±1) で、原点のまわりは山型になっています。(0.2, 0.15) を初期点としてニュートン法を実行すると、極小ではなく極大に到達してしまいます。
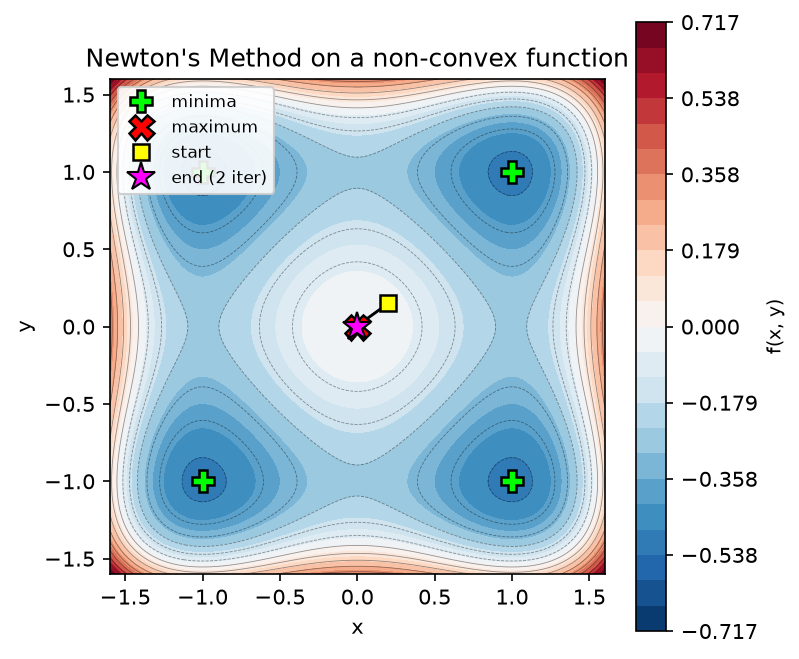
原点では勾配がゼロになっているため、ニュートン法から見ればここは「解」なのです。実際、この初期点でのニュートン法の進む向きは、関数値が増える上り方向を向いています。
ニュートン法のメリットとデメリット
- メリット: 関数が局所的に二次関数でよく近似できる領域では、非常に少ない反復で収束する。
- デメリット: ヘシアンの計算・保存コストが大きい。山型の領域では極大・鞍点に到達することがある。
前半のまとめ
前半では、最急降下法、直線探索法、ニュートン法を紹介しました。最急降下法は勾配の逆向きに進むシンプルな方法で、勾配さえ計算できれば使える手法です。一方で、ステップ幅が大きすぎると発散し、小さすぎると収束に時間がかかるため、ステップ幅の選び方が大切でした。Line Search はこのステップ幅を毎回自動で決める方法で、収束を大きく速めることができました。ただし、進む向きは勾配の逆向きのままです。ニュートン法は勾配に加えてヘシアンも使うことで進む向きそのものを改善し、二次関数でよく近似できる領域では非常に少ない反復数で収束します。一方で、「ヘシアンの計算・保存コストが大きい」「極大や鞍点に到達することがある」という欠点もありました。後半では、ニュートン法を改良してヘシアンを近似する BFGS と、さらに大規模な問題向けにメモリを節約した L-BFGS を紹介します。
参考文献
- Nocedal, J. & Wright, S. J. Numerical Optimization, 2nd ed. Springer, 2006.
- 梅谷俊治『しっかり学ぶ数理最適化 モデルからアルゴリズムまで』講談社, 2020.
- 金森敬文・鈴木大慈・竹内一郎・佐藤一誠『機械学習のための連続最適化』(機械学習プロフェッショナルシリーズ)講談社, 2016.
-


 URLを
コピーしました
新着記事
NEW
Matlantis、imecと機械学習シミュレーションの共同開発プロジェクトを開始
半導体 機械学習ポテンシャル
NEW
材料開発の技術者は、計算化学・MIをどう見ているか――82名への独自調査からわかる二分された現場のギャップ
マテリアルズインフォマティクス 計算化学
The Lab Is (Not) All You Need―― 自律型ラボはなぜ、原子レベルシミュレーションの価値を下げるのではなく、高めるのか
ラボオートメーション 機械学習ポテンシャル
AI for Scienceの最前線 ―「Matlantis User Conference 2026」開催レポート
学会レポート
「物理を再現するAI」で、材料開発の常識を変える――「Matlantis PFP」はいかにして生まれたか
インタビュー